Lokalne AI na dwóch kartach AMD: ROCm, llama.cpp i Nemotron
Czy lokalne AI na dwóch konsumenckich kartach AMD może obsługiwać długi kontekst, narzędzia i programowanie — i przy okazji być rzeczywiście szybkie? Zamiast odpowiadać marketingowym sloganem, postanowiliśmy to zmierzyć. Sprawdzaliśmy różne backendy, wersje kompilacji, kwantyzacje, rozdział modelu między GPU, Flash Attention, techniki spekulatywnego dekodowania i zachowanie modeli pod dużym obciążeniem pamięci.
Efekt był mniej oczywisty, niż sugerowałaby specyfikacja sprzętu. W niektórych scenariuszach jedna karta dawała lepszą responsywność niż dwie. Vulkan potrafił wyglądać bardzo dobrze na krótkim kontekście, lecz przegrywać przy niemal 160 tysiącach tokenów. Większa kwantyzacja modelu okazała się wolniejsza, mimo że teoretycznie miała oferować lepszą jakość. A docelowy Nemotron osiągał w rzeczywistych zadaniach agentowych znacznie wyższy przepływ, niż oczekiwaliśmy na starcie.
To zapis praktycznego eksperymentu: lokalne AI w roli agenta, wraz z pomiarami i potknięciami. Nie jest to instrukcja, że jeden przełącznik „przyspiesza sprzęt o 300%”. Tam, gdzie zmieniał się model, liczba kart albo długość promptu, porównania przedstawiamy z odpowiednim zastrzeżeniem.
Spis treści: TL;DR · Laboratorium · Backend: ROCm vs Vulkan · Test 160K tokenów · Kompilacja llama.cpp · Profilowanie · Strata: RAM vs kwantyzacja · Model MoE dla agenta · Test agenta OpenClaw · Najczęstsze błędy · Wnioski · Czy warto lokalne AI na AMD? · FAQ · Metodologia
TL;DR — najważniejsze wyniki
| Eksperyment | Warunki | Wynik | Co z tego wynika |
|---|---|---|---|
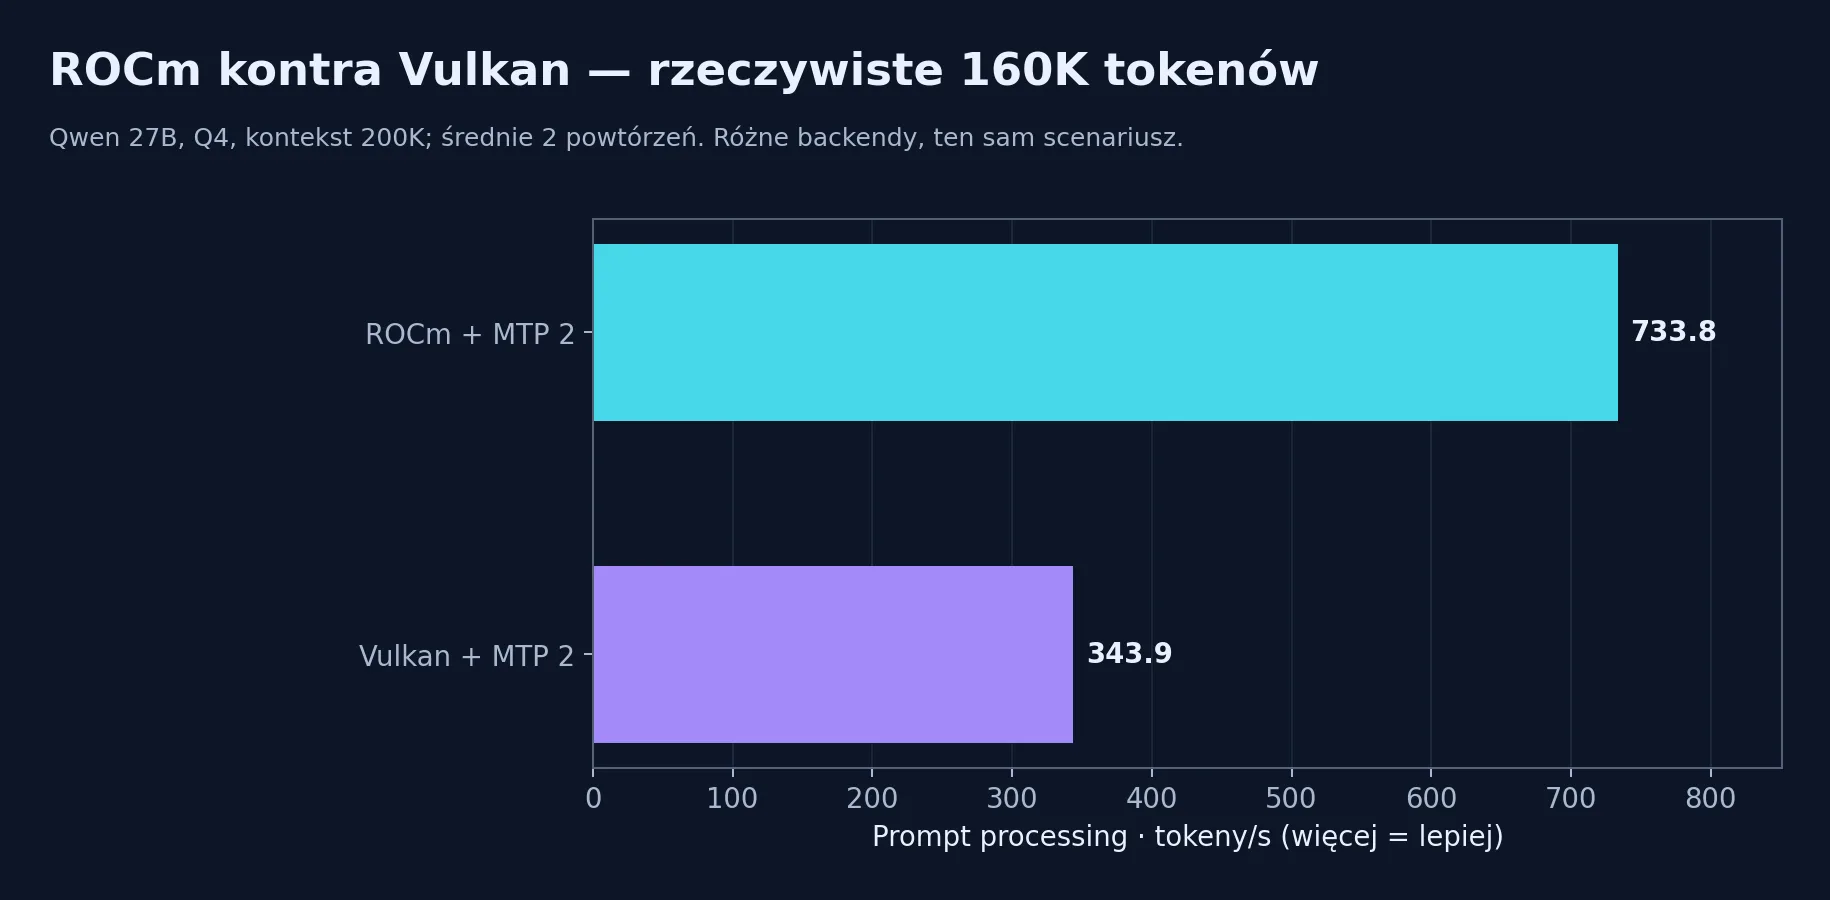
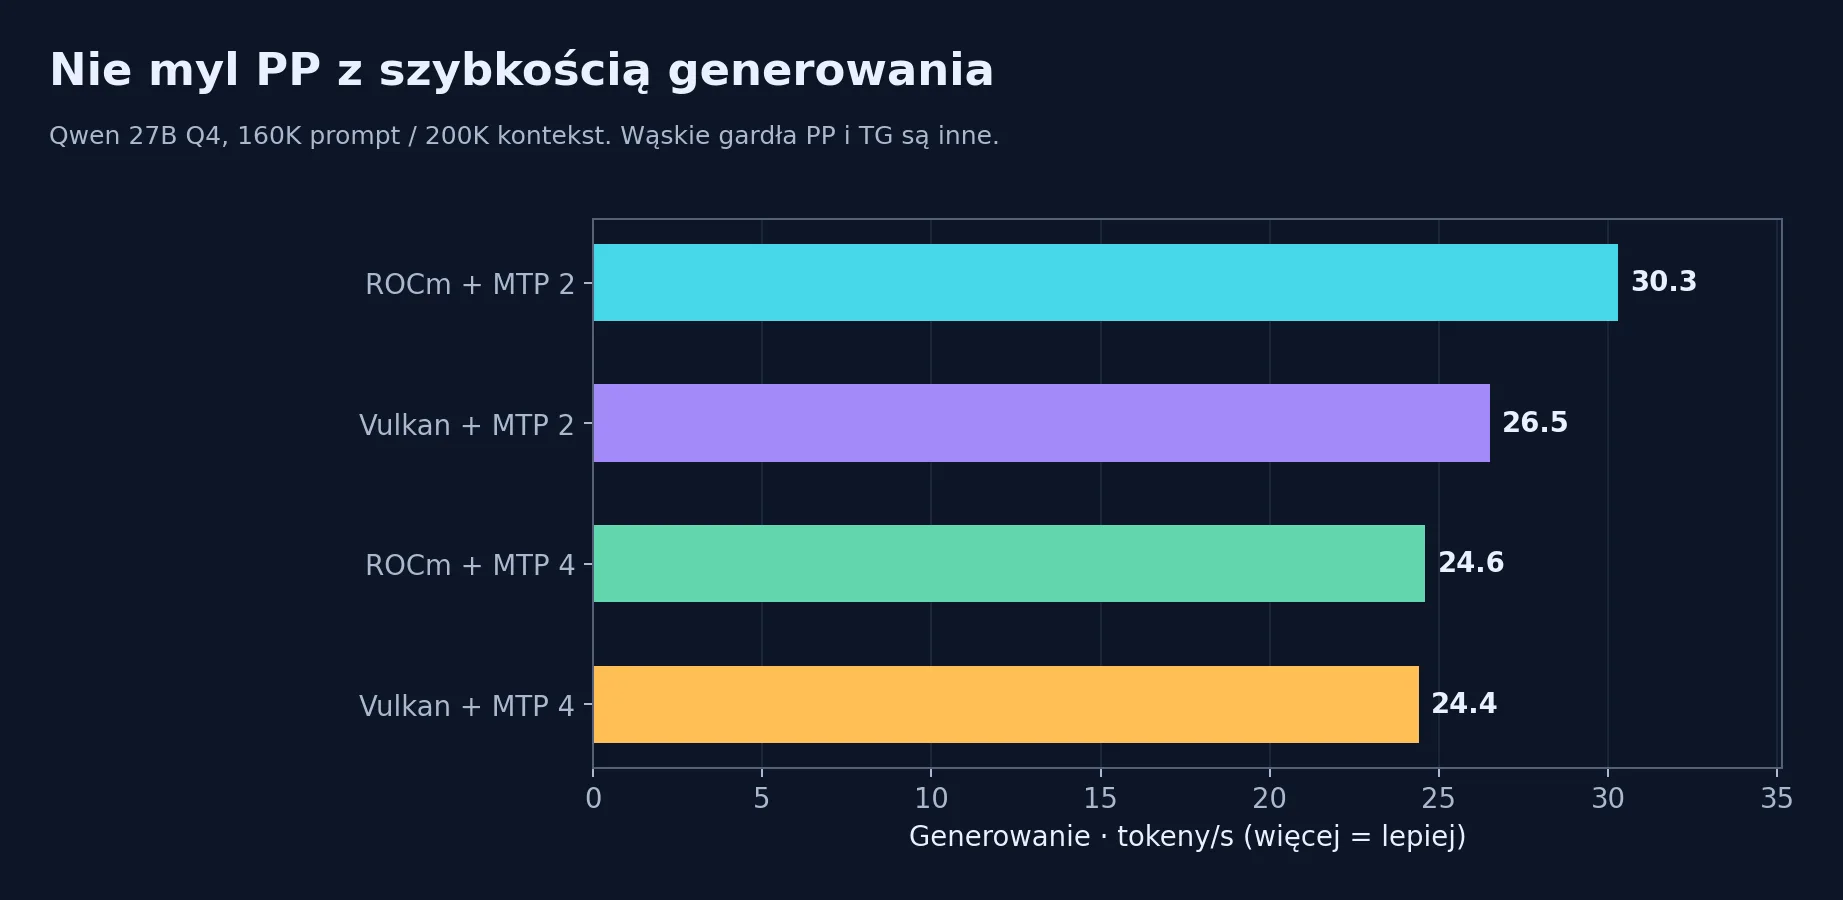
| Qwen 27B Q4, ROCm | 200K kontekstu, 159 520 tokenów wejścia, MTP 2 | 733,8 PP / 30,3 TG | ROCm bardzo mocny przy długim wejściu |
| Qwen 27B Q4, Vulkan | Analogiczny długi prompt, MTP 2 | 343,9 PP / 26,5 TG | Dobry krótki test nie przewiduje długiego kontekstu |
| Qwen 27B Q6, ROCm | 200K, MTP 2 | 723,7 PP / 28,8 TG | Większa precyzja nie dała przyspieszenia |
| Strata Flash-Next IQ3_XXS | Dwa GPU, expert mmap, MTP 4; pięć rzeczywistych żądań | 646,3 PP / 63,2 TG | Istotna przewaga wydajności nad testowaną IQ4 |
| Strata Flash-Next IQ4_XS | Limit RAM 52 GiB, MTP 4; seria pomiarów | 324,3 PP / ok. 36,6 TG | Presja na RAM i stronicowanie niwelują korzyści |
| model mixture-of-experts | llama.cpp ROCm, DFlash, długi kontekst; 20 ukończonych wywołań | 799,5 PP / 88,1 TG | Bardzo obiecująca wydajność agenta; inne obciążenie niż powyżej |
PP = prompt processing (tokeny/s), TG = token generation (tokeny/s). Średnie Nemotrona pochodzą z różnych wywołań OpenClaw, a nie z jednolitego benchmarku. Nie należy traktować powyższej tabeli jako bezpośredniego rankingu modeli.
1. Laboratorium: konsumenckie GPU i specyfika połączeń
Testowaliśmy na stacji roboczej z procesorem wielordzeniowym, płytą główną, dużą ilością pamięci RAM i dwiema kartami graficznymi AMD po dużej ilości pamięci VRAM. Systemem był system Linux z aktualnym kernelem. Oba układy GPU identyfikowały się jako jedna rodzina architektur. Kompilacje i logi trzymaliśmy w wydzielonych katalogach na dysku SSD.
Lokalne AI na dwóch kartach zyskuje niemal podwójną ilość pamięci graficznej, ale nie jest to jedna wspólna, przezroczysta pula pamięci. Backend musi podzielić warstwy i bufory modelu, a wymiana danych między kartami ma koszt. To ma znaczenie szczególnie dla generowania jednego tokenu na raz, gdzie opóźnienie komunikacji łatwo staje się widoczne.
Pułapka PCIe x16
Na początku łatwo uznać, że skoro obie karty znajdują się w fizycznych złączach i same deklarują możliwość pracy ze szybkim standardem, to połączenia do procesora również działają w trybie pełnym. Diagnostyka pokazała jednak istotne rozróżnienie: połączenia od strony portów root pracowały w ograniczonym trybie. W narzędziu diagnostycznym widniało ograniczoną szerokość połączenia dla obu kart.
To nie oznacza awarii. Oznacza, że konfiguracja platformy ma ograniczoną przepustowość komunikacji między CPU i GPU w porównaniu z intuicyjnie oczekiwanym pełnym trybem. W interpretacji eksperymentów wielokartowych trzeba zatem uwzględnić rzeczywistą topologię, nie wyłącznie opis slotów na płycie głównej.
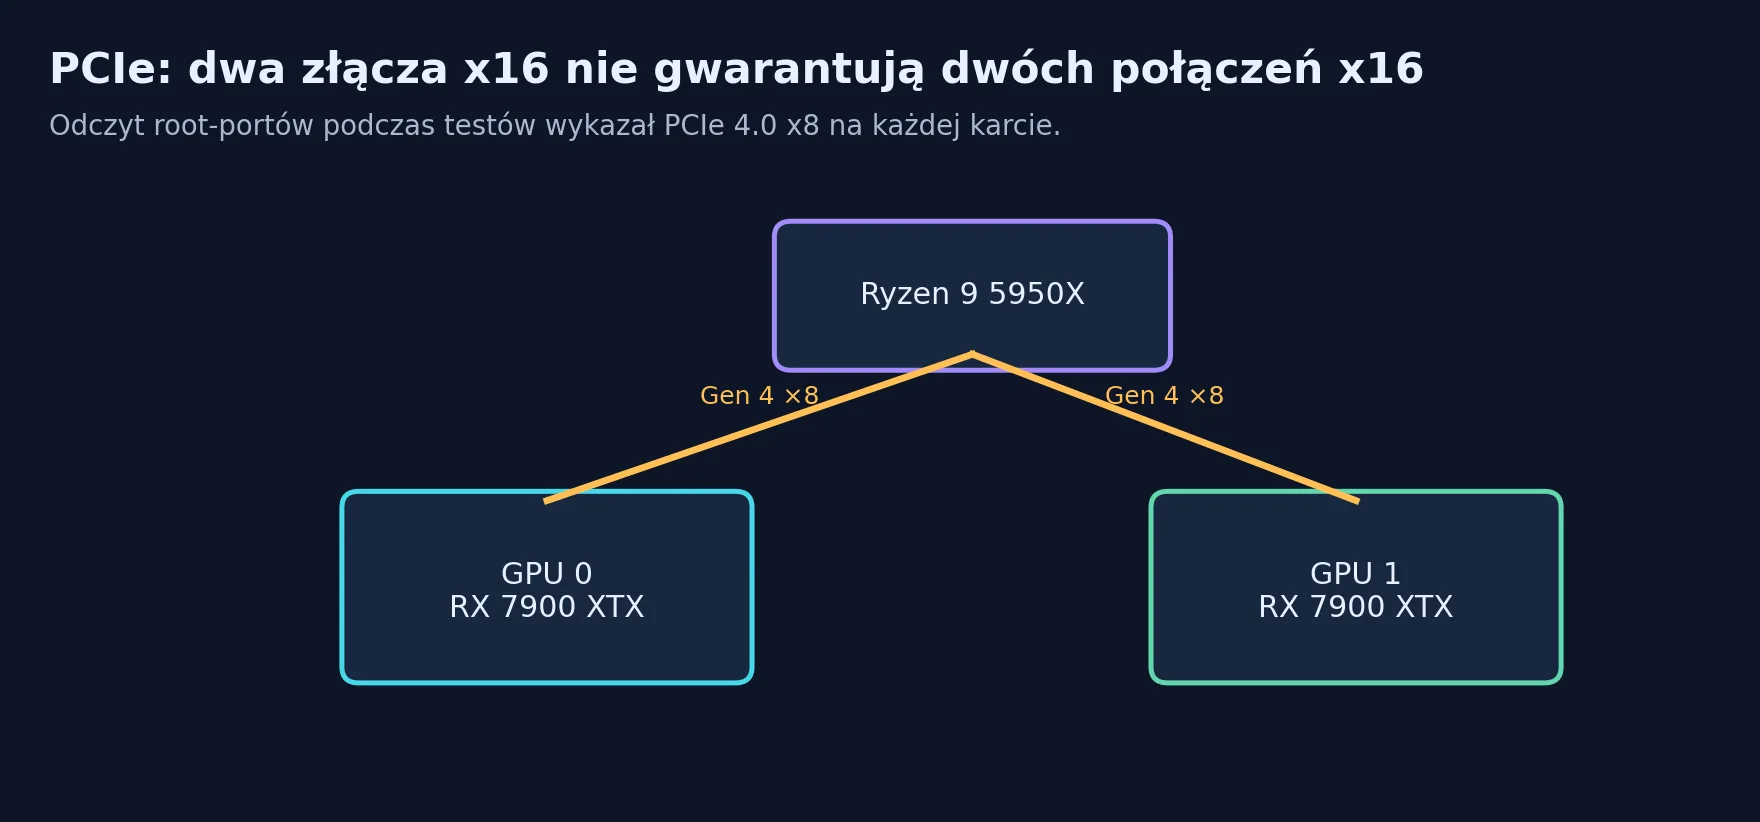
Jak to sprawdzaliśmy: narzędzia diagnostyczne szyny, odczyt sterownika i komunikatów kernela. Dodatkowo kontrolowaliśmy temperatury, zegary, pobór mocy oraz ewentualne błędy resetu, limitu pierścienia i komunikatów PCIe. Sama obecność dwóch urządzeń w narzędziu diagnostycznym nie potwierdza jeszcze poprawnego rozkładu pracy modelu.
2. Najpierw backend, potem model: ROCm kontra Vulkan
W początkowej fazie sprawdzaliśmy, na którym backendzie lokalne AI działa najlepiej: porównywaliśmy uruchamianie modeli GGUF przez Vulkan i ROCm/HIP. Wykorzystywaliśmy także środowisko LM Studio, ale szybko okazało się, że porównanie „aplikacja A kontra aplikacja B” nie wystarcza. Backend, kompilacja llama.cpp, długość kontekstu, rodzaj KV cache i liczba kart potrafią zmienić wynik bardziej niż niektóre parametry modelu.
Przykładowe wcześniejsze obserwacje:
| Wariant i warunki testu | PP [tok/s] | TG [tok/s] |
|---|---|---|
| Qwen 27B Q4, Vulkan, 1 GPU | 904 | 36,6 |
| Qwen 27B IQ4_XS, ROCm, 1 GPU | 516 | 29,3 |
| Qwen 27B IQ4_XS, ROCm, 2 GPU | 364 | 34,7 |
| Qwen 27B IQ4_XS + MTP, ROCm, 1 GPU | 491 | 53,9 |
| Qwen 27B IQ4_XS + MTP, ROCm, 2 GPU | 361 | 69,3 |
| Gemma 4 31B Q8, ROCm, podział warstw na 2 GPU | 960 | 23,4 |
| Gemma 4 31B Q8, ROCm, wariant tensorowy na 2 GPU | 1114 | 32,4 |
To różne modele i konfiguracje z wcześniejszych prób, nie wspólny test kontrolowany. Wniosek był jednak bardzo praktyczny: „dwa GPU” nie jest automatycznym synonimem „dwa razy szybciej”. W jednym przebiegu rośnie TG kosztem PP, w innym warstwowy podział modelu ustępuje wariantowi tensorowemu. Dodanie spekulacji zwiększa prędkość generowania, ale wcale nie musi przyspieszać obróbki promptu.
Dlaczego postanowiliśmy przejść do testów 200K?
Krótkie prompty pozwalają szybko wyłapać nieudane konfiguracje. Nie odpowiadają jednak na pytanie, jak model będzie działał jako agent analizujący repozytorium, historię rozmowy i dokumentację. Przy takich zadaniach wejście może liczyć dziesiątki lub ponad sto tysięcy tokenów. Dlatego potrzebowaliśmy pomiaru z rzeczywiście długim promptem, a nie tylko serwera uruchomionego z parametrem --ctx-size 200000.
3. Test kontrolowany: prawie 160 tysięcy tokenów
Przygotowaliśmy osobny scenariusz benchmarkowy dla Qwena 27B, z kontekstem 200 000 tokenów i wejściem liczącym 159 520 tokenów. Ustawienia obejmowały batch=2048, ubatch=512, warianty MTP=2 i MTP=4, dwa powtórzenia oraz osobne uruchomienia ROCm i Vulkan. Generowanie obejmowało 1024 tokeny.
Wyniki dla Q4 były szczególnie pouczające:
| Backend / MTP | PP [tok/s] | TG [tok/s] |
|---|---|---|
| ROCm / MTP 2 | 733,8 | 30,3 |
| ROCm / MTP 4 | 734,3 | 24,6 |
| Vulkan / MTP 2 | 343,9 | 26,5 |
| Vulkan / MTP 4 | 345,5 | 24,4 |
W tym konkretnym, długim scenariuszu ROCm obsługiwał wejście ponad dwukrotnie szybciej niż Vulkan. Z kolei zwiększenie liczby spekulacyjnie proponowanych tokenów z dwóch do czterech pogorszyło TG. To ważny przykład, dlaczego bardziej agresywne speculative decoding nie musi być szybsze.
Q6 również nie wygrał samą jakością kwantyzacji. Przy ROCm i MTP 2 dawał około 723,7 PP i 28,8 TG. Dla porównania Q4 osiągał 733,8 PP i 30,3 TG. Nie jest to różnica pozwalająca wyciągnąć uniwersalny wniosek o jakości rozumowania — to pomiar przepustowości.
W innym krótkim profilu llama-bench na Q6_K_L przy pp8192 uzyskaliśmy nawet 1721,19 PP, ale jednocześnie tylko 23,89 TG dla tg128. Nie wolno zestawiać tego pierwszego wyniku wprost z PP przy 160K: zakres wejścia, narzut pamięci i warunki testu są inne.
Zaskakujący problem: zajęty port, choć proces już się kończył
Automatyczny sweep natknął się na uporczywie zajęty port. Skrypt wykonywał pomiar, zatrzymywał serwer i przez kolejne około 60–64 sekundy czekał, aż port stanie się ponownie dostępny. Część konfiguracji przy wcześniejszych próbach kończyła się komunikatem o zajętym porcie.
Wydawałoby się, że to drobiazg, lecz przy kilkunastu kombinacjach kosztuje to wiele minut i może fałszować ocenę „jak szybko przebiegł benchmark”. Od tej pory rozdzielaliśmy:
1. Czas obliczeń modelu — raportowany przez backend. 2. Czas ścienny (wall time) — obejmujący start, wczytanie, warm-up, zamykanie i oczekiwanie na port. 3. Pomiary nieukończone — oznaczane jako błąd, nie jako zero tok/s.
To jeden z najbardziej praktycznych wniosków z całej serii: skrypt benchmarkowy też trzeba testować.
4. Droga do własnego ROCm i kompilacji llama.cpp
Kiedy wyniki gotowych backendów przestały wystarczać, przenieśliśmy eksperymenty do oddzielnego laboratorium z własnymi kompilacjami llama.cpp dla HIP. W logach projektu nazywaliśmy je rocm-nowy; chodziło o nowszą wersję ROCm, a nie oficjalny numer wydania. W używanym środowisku kompilator raportował własną wersję, a kompilator był oparty na nowoczesnym kompilatorze C.
Stan źródeł llama.cpp wykorzystany w najnowszych próbach był oznaczony niedawnym commitem. W laboratorium powstało kilka niezależnych wariantów buildów, m.in.:
rocm-nowy
rocm-nowy-wave64
rocm-nowy-fa-batch32
rocm-nowy-fa-rdna-128
rocm-nowy-fa-q-lds32
To nie są nazwy oficjalnych wydań upstreamu; to oznaczenia naszych eksperymentalnych kompilacji. Nie mamy dowodu, że ostatni build jest automatycznie najszybszy dla każdego modelu. Jest natomiast konkretnym, uruchomionym i testowanym wariantem.
Co komplikowało kompilację na architekturze GPU?
Eksperymenty z wavefrontami i WMMA nie zawsze kończyły się udanym buildem. Jedna z prób wave64 dla architekturę GPU zatrzymała się na błędzie kompilatora:
error: '__builtin_amdgcn_wmma_f32_16x16x16_f16_w32'
       needs target feature wmma-256b-insts
       when compiling for architekturę GPU
To cenna lekcja: nie każdy wariant optymalizacji przeznaczony dla architektur AMD można bezkarnie połączyć z innymi ustawieniami wavefrontów. Nie jest to dowód, że karta „nie obsługuje AI”; to konflikt konkretnego intrinsic i zestawu cech docelowych podczas kompilacji. Kolejne próby z eksperymentalnymi kernelami także przyniosły dziesiątki ostrzeżeń i błędy budowania, więc problem rozwiązywaliśmy przez oddzielne warianty buildów i porównywanie ich, a nie bezpośrednie nadpisywanie działającego pliku wykonywalnego.
W jednej z faz do profilowania wykorzystaliśmy także narzędzia do profilowania GPU, przekazując odpowiednie urządzenia oraz jawnie ustawiając środowisko. To umożliwiło zebranie kernel traces bez mieszania zależności laboratoryjnych z resztą systemu.
Minimalny sensowny punkt wyjścia dla HIP
Poniższy przykład to szablon, a nie wierna kopia wszystkich flag z naszych kolejnych, eksperymentalnych buildów. Wersje flag CMake mogą zmieniać się między commitami:
HIPCXX="$(hipconfig -l)/clang" \
  HIP_PATH="$(hipconfig -R)" \
  cmake -S . -B build-rocm \
  -DGGML_HIP=ON \
  -DGPU_TARGETS=architekturę GPU \
  -DCMAKE_BUILD_TYPE=Release

cmake --build build-rocm -j 16
Zawsze warto potwierdzić opcje w dokumentacji dokładnie tego commitu źródeł, który kompilujemy. Aktualna dokumentacja projektu opisuje backend HIP, GPU_TARGETS oraz typowe problemy z bibliotekami urządzeń ROCm: llama.cpp — build documentation.
5. Profilowanie: gdzie naprawdę znika czas GPU?
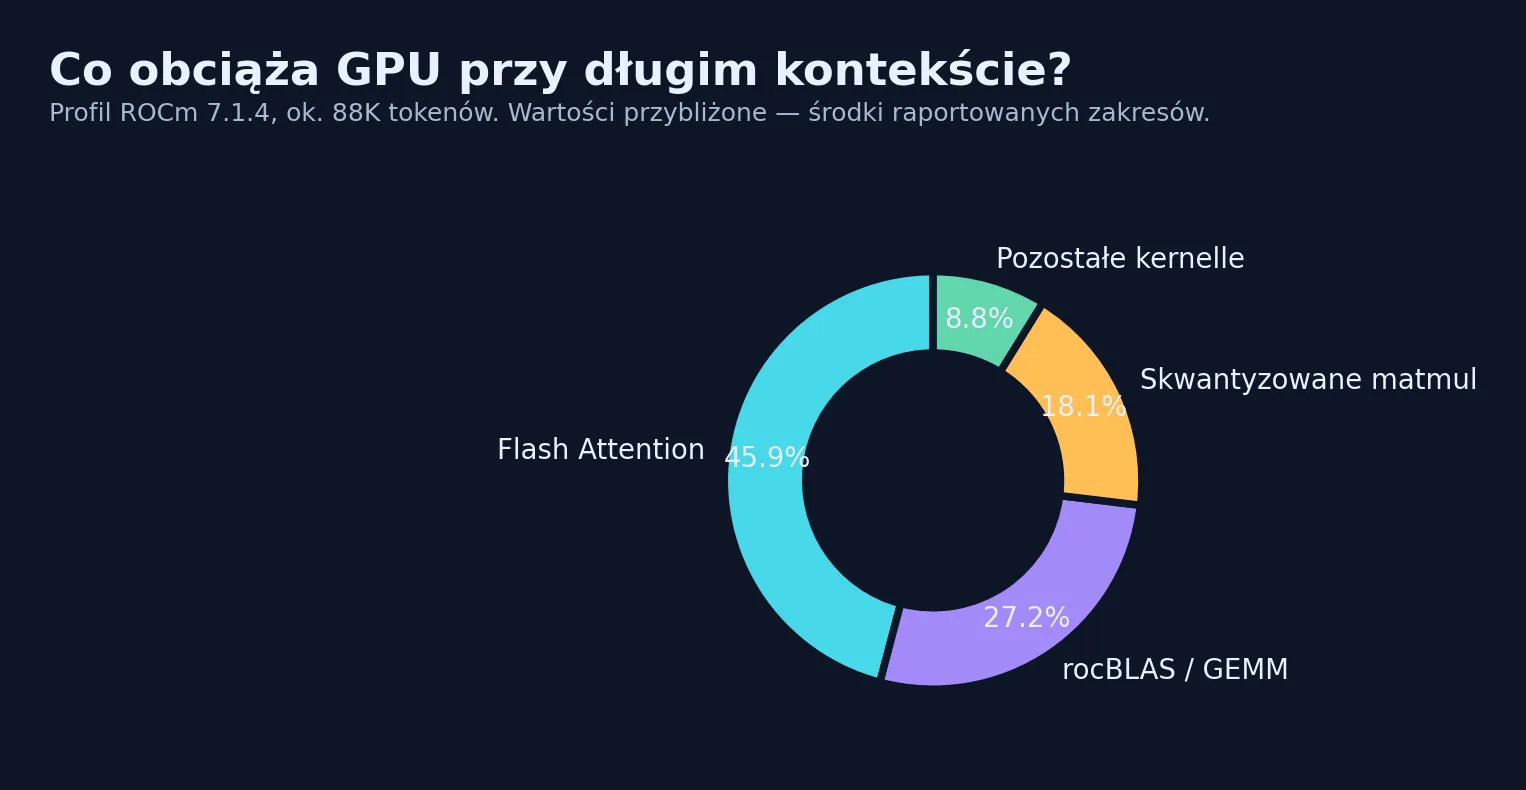
Zamiast zgadywać, że winny jest „wolny ROCm”, uruchomiliśmy profiler. W jednym z długich scenariuszy około 88K tokenów największym składnikiem czasu GPU była obsługa Flash Attention:
| Grupa operacji | Udział w czasie kerneli |
|---|---|
| Flash Attention | około 44,0–47,7% |
| rocBLAS / GEMM | około 26,9–27,5% |
| Skwantyzowane mnożenie macierzy | około 16,9–19,2% |
| Pozostałe operacje | Reszta |
W pojedynczym pomiarze związanym z tym etapem odnotowaliśmy około 957,94 PP, 30,71 TG oraz akceptację spekulacji 587 z 871 tokenów (67,4%). To wynik określonego profilu, a nie średnia globalna dla ROCm.
Wniosek: gdy lokalne AI dostaje długi kontekst, Flash Attention staje się jednym z głównych pól do optymalizacji. W takich warunkach strojenie kerneli, rozmiarów kafelków i wykorzystania pamięci lokalnej (LDS) ma więcej sensu niż ślepe podbijanie liczby tokenów draftu.
Równocześnie trzeba pamiętać o napięciu między PP i TG. GPU może bardzo wydajnie przetwarzać duży blok tokenów, ale generowanie autoregresyjne pozostaje innym problemem: mniej pracy równoległej na krok i większa wrażliwość na przepustowość pamięci oraz overhead synchronizacji.
6. Strata Flash-Next: kiedy lepsza kwantyzacja przegrywa z pamięcią RAM
Następny etap dotyczył innego rodzaju problemu: lokalne AI potrafi wyhamować nie na GPU, lecz na pamięci RAM. Strata / Qwen3.8-Flash-Next to eksperyment z dużym modelem, którego pełna struktura ekspertów przekracza pamięć konsumenckich GPU. Aby zmieścić model w naszych zasobach, wykorzystaliśmy niskopamięciowy tryb mmap dla wag ekspertów, rozkład pracy na dwie karty oraz MTP (Multi-Token Prediction).
W lokalnym procesie przygotowania pakietu IQ3_XXS pojawiły się m.in.:
– Dwa pliki GGUF z głównym modelem.
– Wydzielony plik experts.bin o wielkości około 39,97 GiB.
– Pobierane oddzielnie tensory MTP, w logu o rozmiarze około 5,21 GB.
– --context 204800, KV cache 8-bit i tryb niskiego użycia RAM.
– Zależność od systemowego page cache, a nie wyłącznie od VRAM.
Przy takiej konstrukcji sam rozmiar GGUF przestał być najważniejszą liczbą. Liczyły się RAM dostępny dla procesu, cache stron, liczba błędów stron i presja na pamięć. Podniesienie limitu RAM z 48 do 52 GiB pomagało, ale nie czyniło wariantu IQ4 szybszym od IQ3.
Porównanie z realnych sesji
| Wariant | Limit pamięci | PP [tok/s] | TG [tok/s] | Uwagi |
|---|---|---|---|---|
| IQ3_XXS, MTP4 | 44 GiB | 646,3 | 63,2 | 5 kolejnych żądań, różne poziomy reuse cache |
| IQ4_XS, MTP4 | 48 GiB | 282,1 | 23,3 | 2 żądania, silna presja pamięci |
| IQ4_XS, MTP4 | 52 GiB | 324,3 | ok. 36,6 | Seria pomiarowa po zwiększeniu limitu RAM |
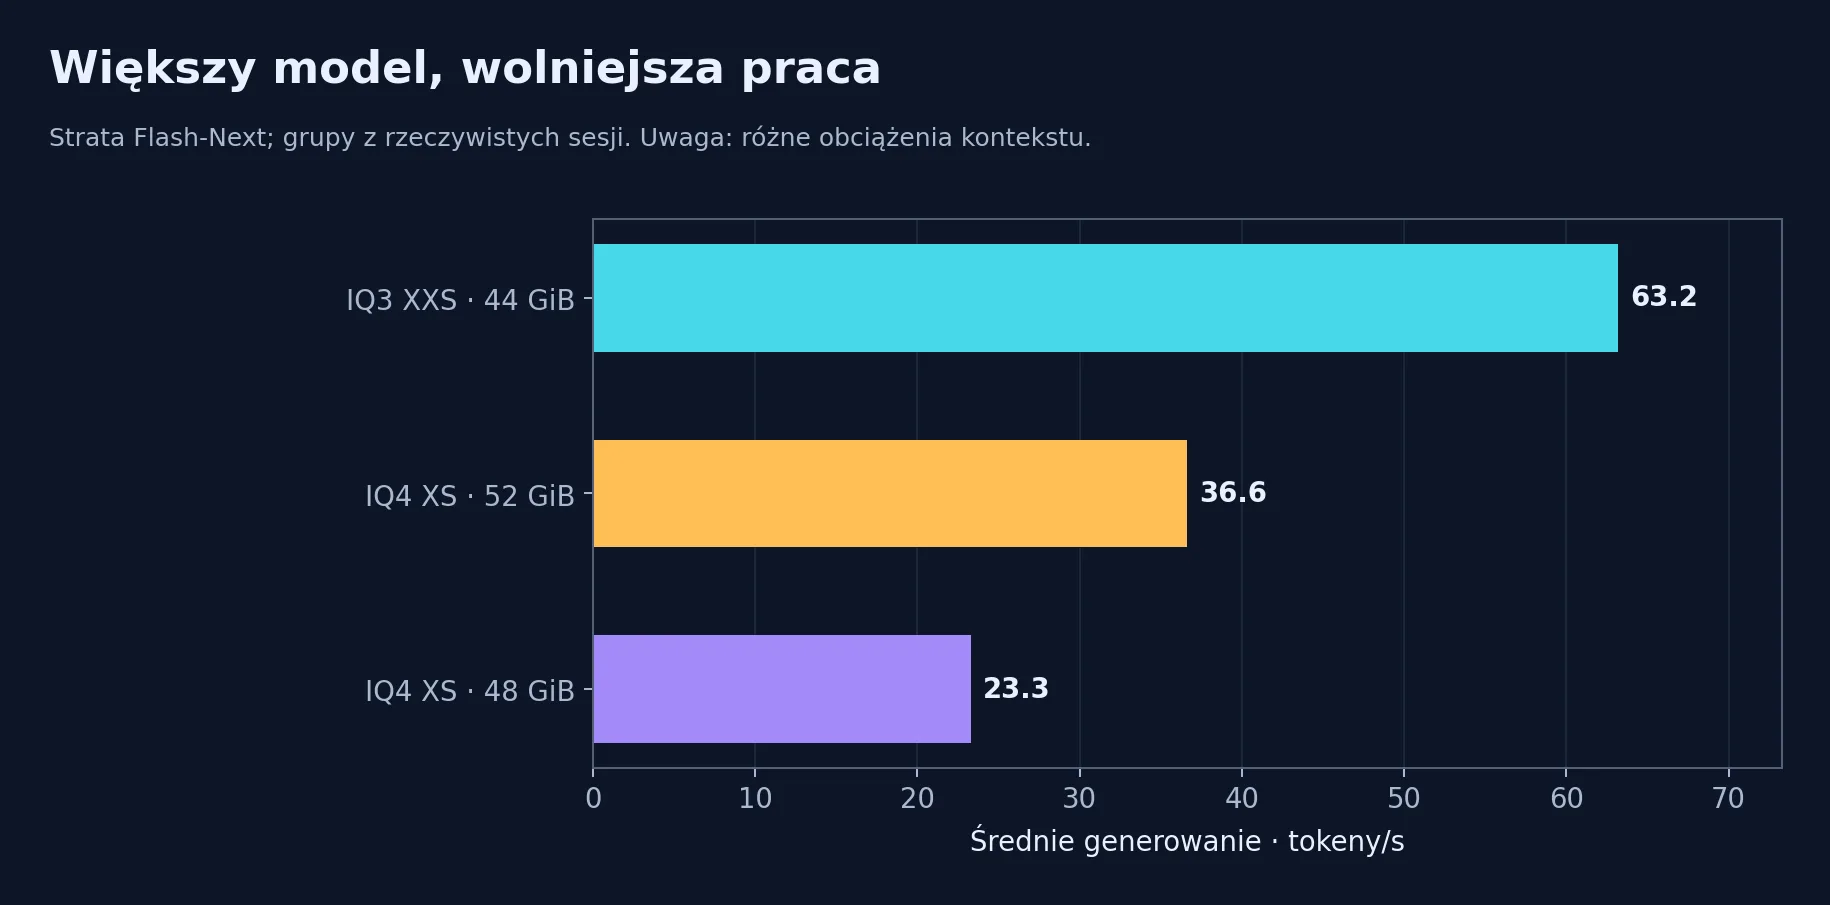
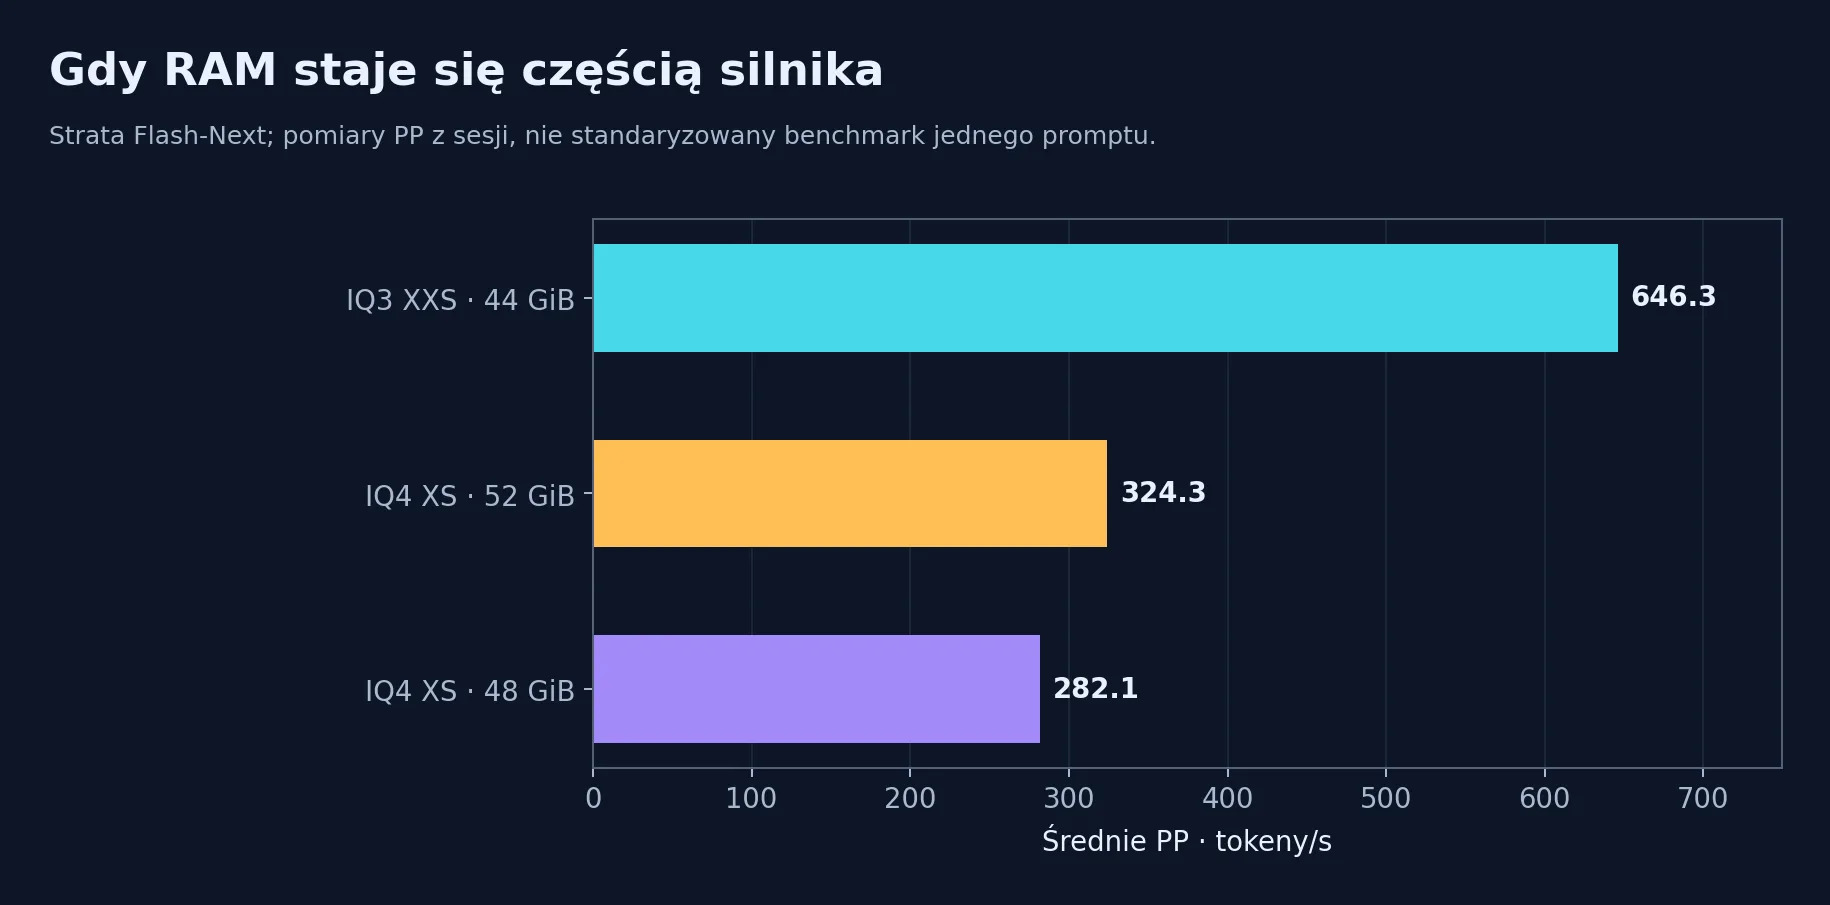
W gorszym wariancie IQ4 obserwowaliśmy również intensywne skanowanie i odzyskiwanie stron pamięci: w odcinku około 10 sekund przyrosty pgscan oraz pgsteal sięgały około 589–591 tysięcy. To znacznie bardziej przekonujące wyjaśnienie spadku wydajności niż stwierdzenie, że „IQ4 jest po prostu za wolne”.
> Paradoks eksperymentu: większa dokładność wag nie dała większej wydajności. W tym konkretnym środowisku IQ3_XXS lepiej mieścił się w budżecie pamięci, dzięki czemu cała ścieżka inferencji pracowała sprawniej.
Dwie rzeczy, których nie wolno tu przemilczeć
Po pierwsze, wyniki Strata pochodzą z realnych, kolejnych żądań agenta; różniły się długości promptów i udziałem już przetworzonych tokenów. Nie jest to izolowany benchmark o idealnie jednakowym wejściu. Po drugie, większa precyzja wag może przynosić korzyści jakościowe, które nie zostały rozstrzygnięte tym pomiarem szybkości. Nasze zestawienie odpowiada na pytanie „co było szybsze w tym sprzęcie i ustawieniach?”, a nie „która kwantyzacja jest najinteligentniejsza?”.
Niestabilność i błędy weryfikacji draftu
Podczas prób Strata zdarzały się komunikaty typu verify: timed out at layer 29 (GPU1), a proces serwera wymagał ponownego uruchomienia. Nie mamy w tych logach potwierdzenia krytycznego resetu karty przez sterownik, więc nie należy automatycznie nazywać tego awarią sprzętu. Raczej traktowaliśmy to jako problem konkretnej ścieżki wykonania lub synchronizacji przy weryfikacji draftu. Ważne było zachowanie działającego wariantu IQ3 jako punktu powrotu.
W dodatkowej próbie z MTP2 uzyskaliśmy przeciętnie około 640,8 PP i 53,8 TG. Powrót do MTP4 dawał w wykorzystanej serii około 646,3 PP i 63,2 TG. W tym przypadku bardziej agresywna spekulacja pomagała — odwrotnie niż w niektórych długokontekstowych próbach Qwen 27B. Nie ma jednego uniwersalnego „najlepszego MTP”.
7. Model mixture-of-experts, który zmieścił się w projekcie lokalnego agenta
Po sprawdzeniu backendów i pamięci przeszliśmy do modelu rodziny mixture-of-experts, skompresowanego i skwantyzowanego w sposób pozwalający uruchamiać duży model przy stosunkowo ograniczonej pamięci. Szukaliśmy modelu, który zapewni lokalne AI z obsługą narzędzi i długim kontekstem, bez wywołań do chmury. Według oficjalnego opisu producent wariant zaprojektowano z myślą o lokalnych zadaniach agentowych i dużej efektywności względem pamięci (materiał techniczny producenta).
Na naszym systemie przygotowaliśmy trzy pliki:
| Składnik | Około | Funkcja |
|---|---|---|
| Główny GGUF model mixture-of-experts | 21 GB na dysku | Generowanie tekstu i rozumowanie |
mmproj |
1,7 GB | Obsługa wejścia wizualnego |
LiLiCorr |
953 MB | Draft model dla DFlash |
Nie oznacza to, że wszystkie struktury modelu zajmują dokładnie 24 GiB VRAM w czasie pracy. Rozmiar pliku, pamięć wag, bufory obliczeń i cache KV to różne pojęcia. W stanie bezczynności proces zajmował łącznie około 29,6 GiB VRAM na dwóch kartach.
Konfiguracja, która zadziałała
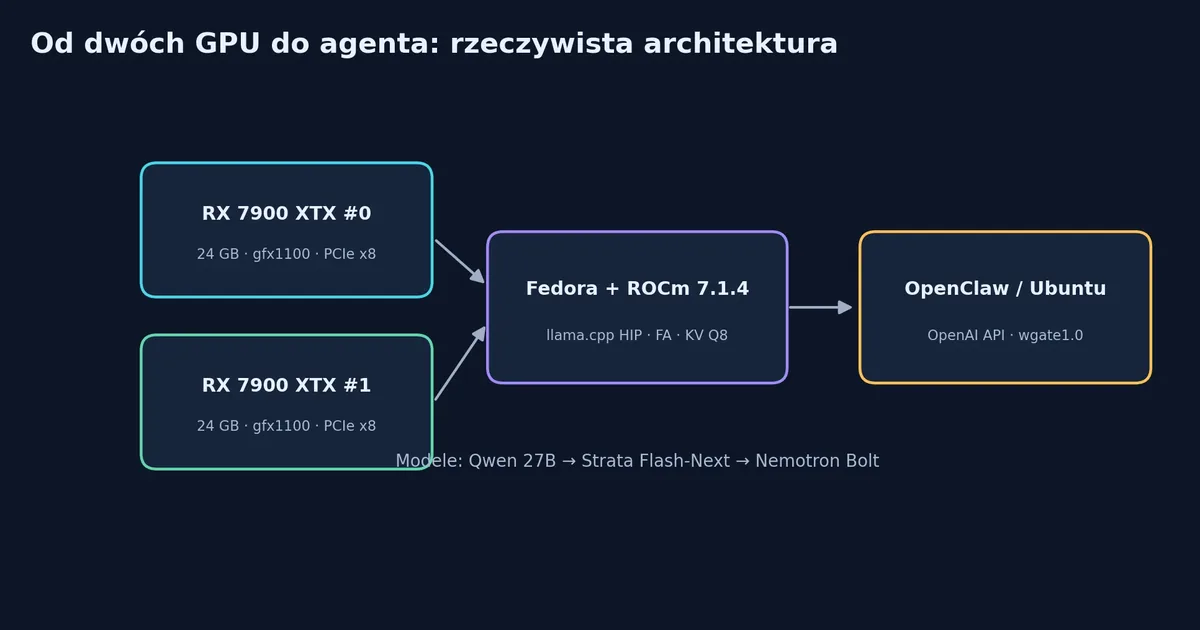
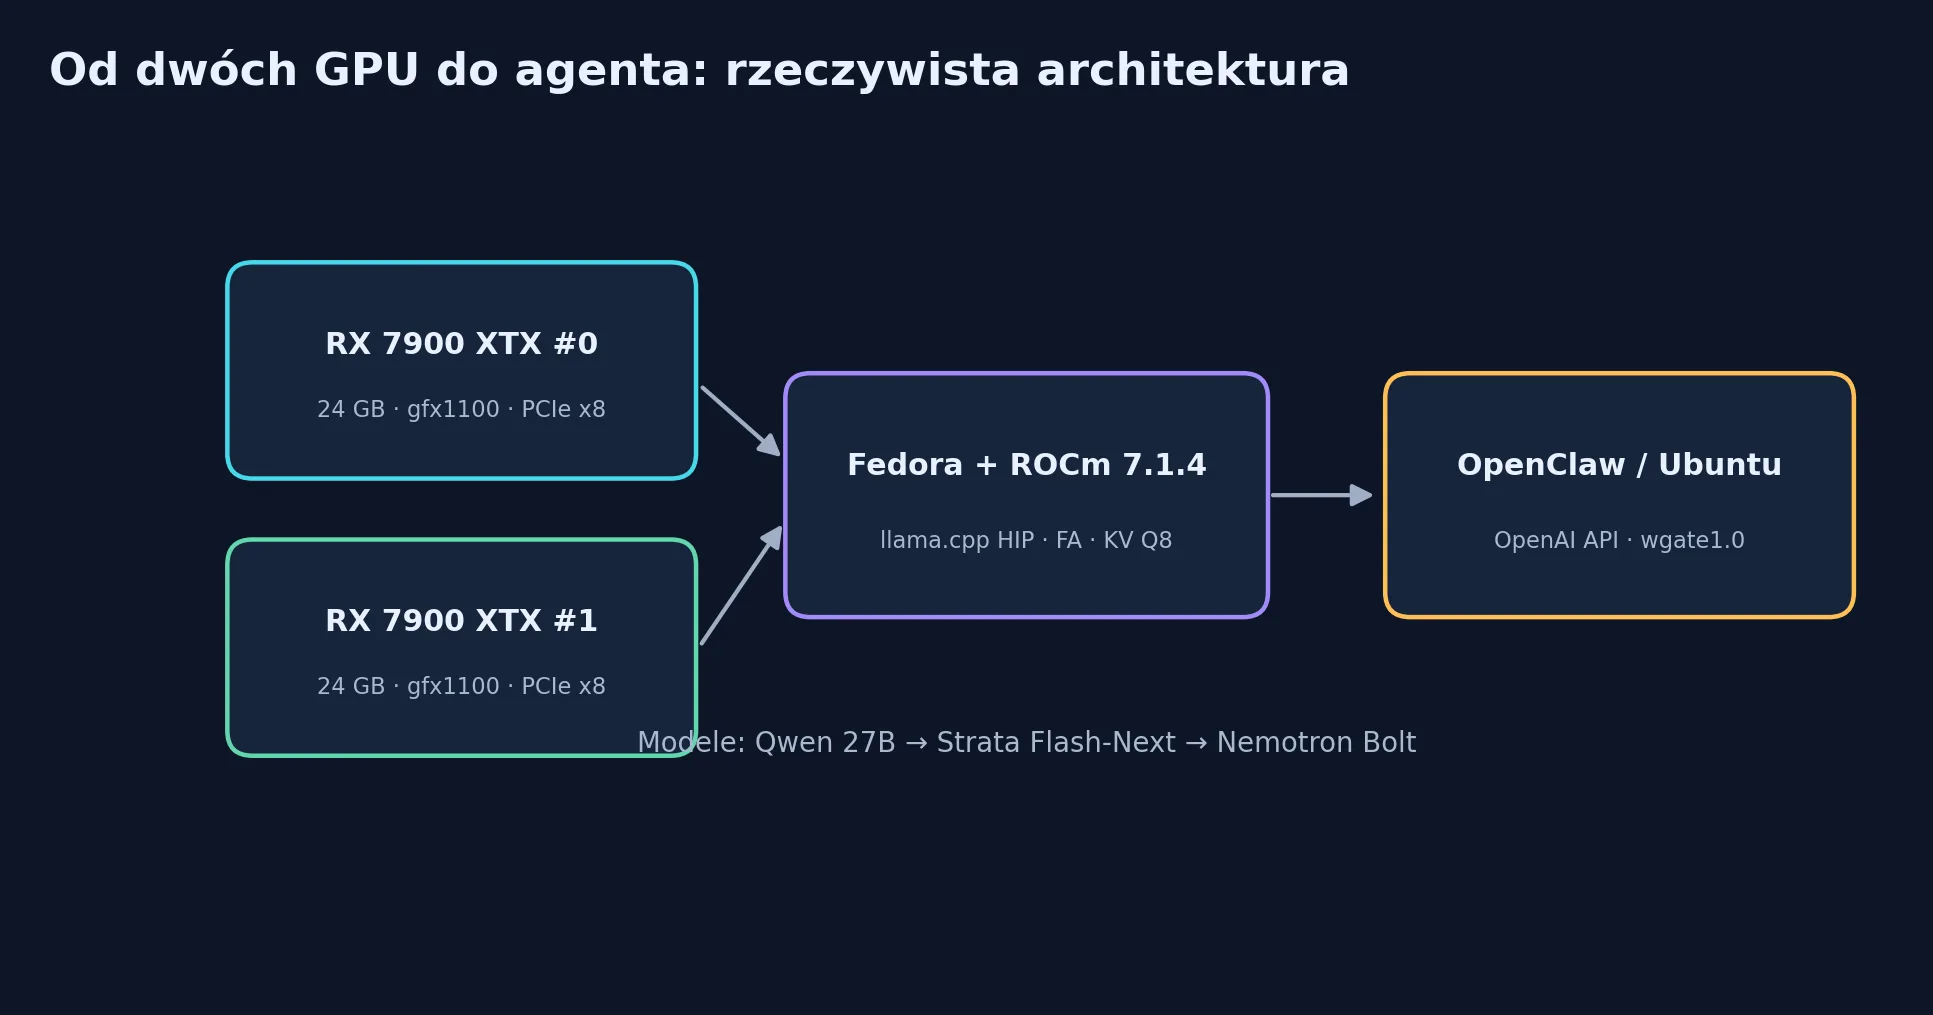
Docelowy llama-server został uruchomiony z dwoma kartami graficznymi AMD, pełnym offloadem warstw, Flash Attention, KV cache Q8_0, kontekstem 204 800 i spekulatywnym dekodowaniem DFlash / LiLiCorr z maksymalnie sześcioma proponowanymi tokenami. Model był udostępniony przez API zgodne ze standardem branżowym, z aliasem wgate1.0, żeby OpenClaw nie musiał zmieniać identyfikatorów przy kolejnych podmianach silnika.
Przykładowa redakcyjna konfiguracja (bez adresów infrastruktury i sekretów):
./llama-server \
  --model /MODELE/nemotron-24gb.gguf \
  --mmproj /MODELE/mmproj-24gb.gguf \
  --host LOKALNY_HOST --port PORT \
  --alias wgate1.0 \
  --ctx-size 204800 --parallel 1 \
  --n-gpu-layers 999 --split-mode layer \
  --flash-attn on \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --batch-size 2048 --ubatch-size 512 \
  --spec-type draft-dflash \
  --spec-draft-model /MODELE/nemotron-lilicorr.gguf \
  --spec-draft-n-max 6 --spec-draft-ngl 999 \
  --reasoning-budget 10000 \
  --jinja --temp TEMPERATURA --top-p TOP_P
Ten zapis pokazuje konfigurację fazy testowej, nie obowiązkowe ustawienia producenta. W dalszych rozmowach rozważaliśmy podniesienie thinking budget do 16 384 tokenów i limitu generacji agenta do 32 768; nie traktujemy samych planów zmiany jako odrębnego zmierzonego benchmarku. Podobnie --ctx-size 204800 oznacza przydział kontekstu, nie dowód, że każda próba przetworzyła pełne 204 800 tokenów.
DFlash: drafter pracuje, ale jego skuteczność nie jest stała
W pierwszych testach Nemotrona akceptacja propozycji DFlash wynosiła w dwóch próbach około 53,8% i 59,8%, a w krótkim wywołaniu narzędzia około 71%. Późniejsze logi zadaniowe pokazały szeroki rozrzut — od około 23% do ponad 90% w małych próbach.
To naturalne: efektywność spekulacji zależy od rozkładu generowanych tokenów i charakteru zadania. Krótka, przewidywalna odpowiedź może mieć wysoką akceptację. Złożone rozumowanie lub kod często prowadzą do innych wartości. Draft acceptance jest metryką pomocniczą, nie końcową oceną prędkości.
8. Prawdziwy test Nemotrona: OpenClaw zamiast syntetycznego benchmarku
Najważniejszy moment nastąpił, gdy lokalne AI stało się głównym agentem OpenClaw. Agent otrzymał wieloetapowe zadania: rozpoznanie systemu, inspekcję konfiguracji, przegląd kodu, zadania logiczne i przygotowanie implementacji w Pythonie. Później rozpoczął również testy programistyczne obejmujące scheduler, atomowy zapis JSON oraz integrację Python/PHP.
W zapisanym logu serwera z sesji agentowej znaleźliśmy 20 ukończonych wywołań, dla których można sparować prompt eval time i eval time:
– Średnie PP: 799,5 tok/s. – Średnie TG: 88,1 tok/s. – Najwyższe TG w tej grupie: 131,9 tok/s — dla krótkiej generacji, więc nie jest to stabilna prędkość długiej odpowiedzi. – Występowały także długie generacje, np. 7666 tokenów przy 76,3 TG.
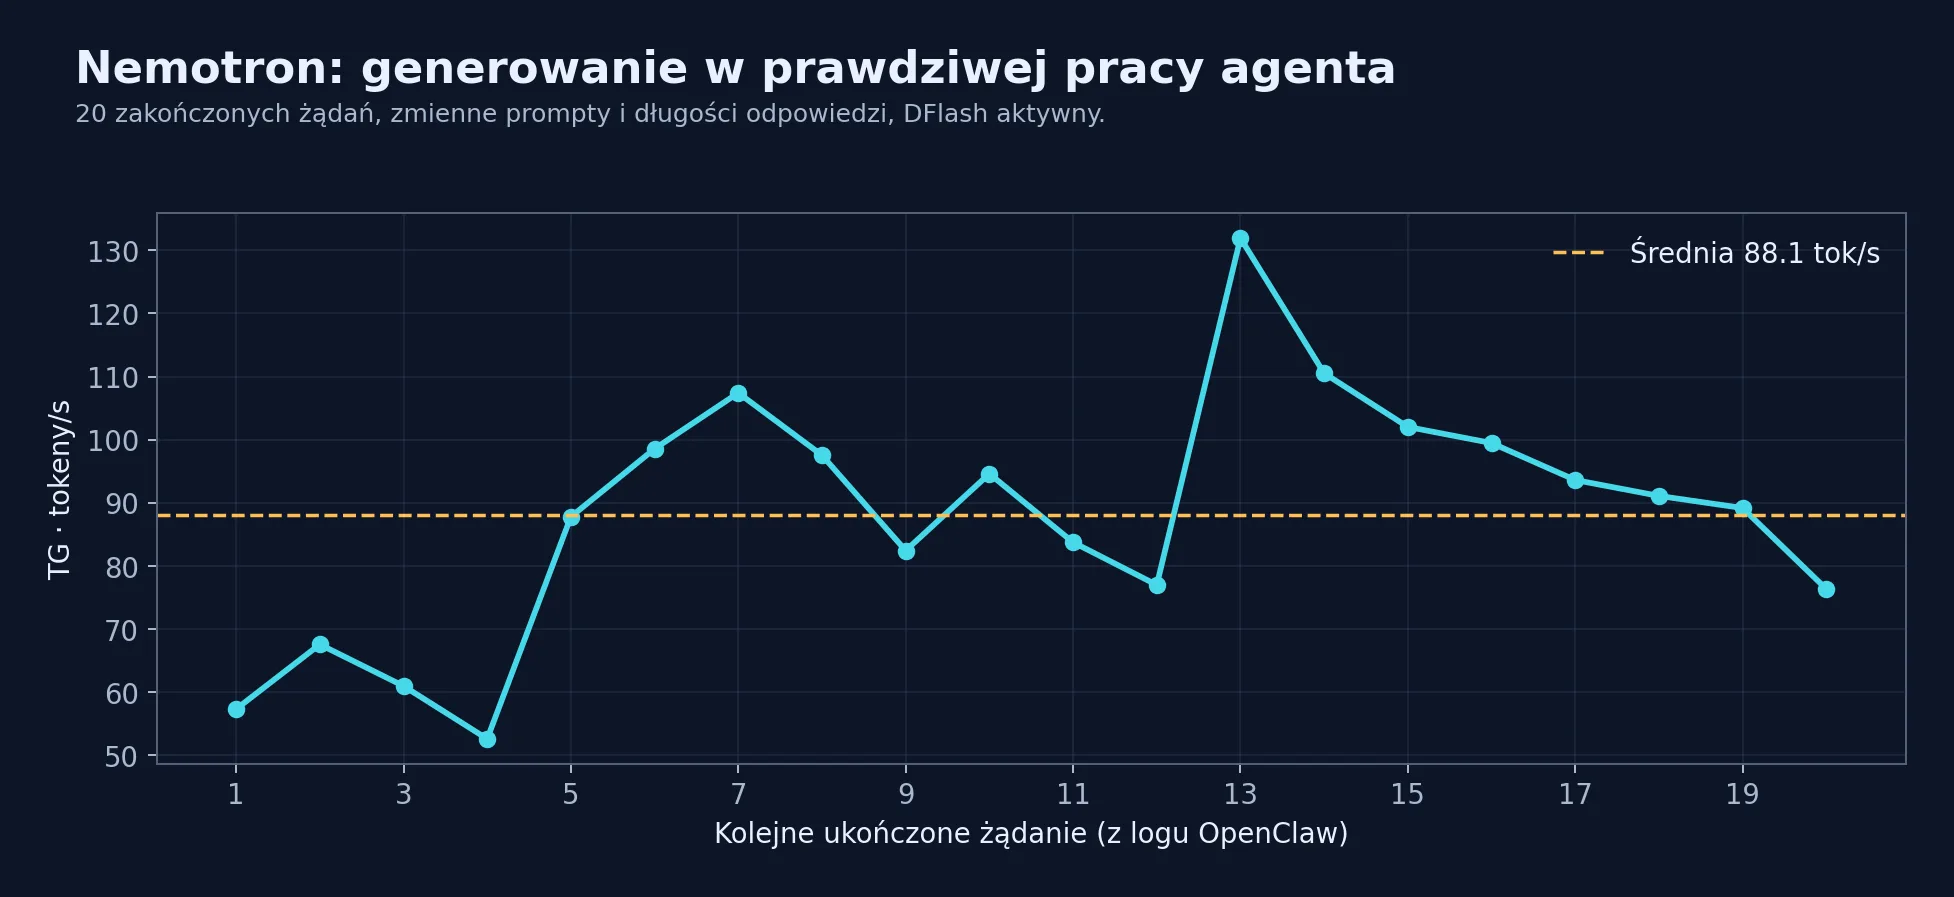
Szczególnie ciekawy jest przypadek długiego prefilla: jeden log pokazuje przetwarzanie promptu przekraczającego 132 000 tokenów, a przy około 130 787 tokenach raportowane tempo wynosiło 1356,7 tok/s. To żądanie zostało jednak anulowane przed ukończeniem, więc uczciwie opisujemy je jako obiecujący przebieg częściowy, nie zaliczony test pełnych 200K. W późniejszych ukończonych wywołaniach serwer korzystał z podobieństwa prefiksu promptu i ponownie używał części cache.
W logach pojawiały się także incydentalne unauthorized: Invalid API Key. Nie można ich mylić z problemami wydajności modelu: były to odrzucenia pojedynczych żądań uwierzytelniania, przy równoległej obecności prawidłowo obsługiwanych wywołań. Do publikacji nie trafiają żadne wartości kluczy.
A jakość? Nie wszystko przeszło idealnie
Nemotron wykonał wieloetapowy audyt i poprawnie rozwiązał problem harmonogramowania: 22 sekundy z równoległością i 27 sekund przy jednym pracowniku. Potrafił też korzystać z narzędzi i korygować część własnych problemów. W kolejnym teście zgłosił 24/24 przechodzące testy dla dwóch modułów Pythona: zapisu atomowego i schedulera. To relacja z przebiegu testu, a nie niezależnie wykonana przez autora walidacja całego repozytorium.
Były jednak również potknięcia. W jednym z wcześniejszych wygenerowanych zestawów testów Pythona znalazły się wadliwe założenia i błędy testów, których model nie wychwycił w samym opisie. W audycie OpenClaw mylnie uznał brak modelu embeddingowego na allowliście agentów za możliwą sprzeczność, mimo że wyszukiwanie wektorowe jest odrębnym mechanizmem. To istotna różnica między modelem potrafiącym napisać wiarygodnie brzmiący raport a modelem, którego wynik został sprawdzony uruchomieniem kodu i niezależnymi testami.
Lokalne AI w firmie to więc dwa zakresy pomiarów: wydajność infrastruktury i jakość działania agenta. Bez drugiej klasy nawet spektakularne tok/s niewiele mówi o przydatności biznesowej.
9. Najczęstsze błędy i jak je interpretowaliśmy
| Objaw | Kontekst eksperymentu | Poprawna interpretacja |
|---|---|---|
| Jedna karta bywa szybsza od dwóch w PP | Wczesne porównania backendów | Overhead podziału i komunikacji może przeważyć nad korzyścią |
| Wolny TG przy wysokim PP | Różne scenariusze Qwen 27B | Prefill i dekodowanie obciążają sprzęt inaczej |
| MTP4 gorszy od MTP2 | Qwen Q4, długi kontekst | Więcej spekulacji nie gwarantuje większej akceptacji ani wydajności |
| IQ4 wolniejszy od IQ3 | Strata, ograniczony RAM | Cache stron / reclaim / memory pressure może dominować |
wmma-256b-insts w kompilatorze |
Eksperymentalny build wave64 | Niekompatybilna kombinacja intrinsic/target feature dla danej ścieżki |
| Port zajęty po zatrzymaniu serwera | Automatyczny sweep | Trzeba kontrolować lifecycle procesu i odróżniać wall time od inferencji |
verify timed out at layer 29 |
Strata, GPU1 | Błąd ścieżki wykonania; sam wpis nie dowodzi resetu GPU |
Invalid API Key |
Serwer Nemotron podczas testów | Błąd uwierzytelnienia konkretnego klienta, nie błąd inferencji |
| Model „twierdzi, że testy przechodzą” | Test programistyczny | Potwierdzać rzeczywistym uruchomieniem testów i kodami wyjścia |
Czego nauczyliśmy się o bezpieczeństwie eksperymentów?
Najważniejsza zasada była prosta: nie niszczyć działającego punktu odniesienia. Warianty kompilacji, logi i modele trafiały do oddzielnych katalogów. Nie zamykaliśmy obcych procesów tylko dlatego, że zajmowały port benchmarkowy. Nie publikujemy też w artykule prawdziwych adresów wewnętrznych serwerów, kluczy API ani fragmentów prywatnego openclaw.json.
10. Osiem technicznych wniosków, które naprawdę coś zmieniają
1. Mierz dwa światy: PP i TG. Przy 160K tokenów przetwarzanie wejścia jest równie ważne jak tempo odpowiedzi. Jeden wynik „tokens per second” nie wystarczy.
2. Kontekst zadeklarowany to nie kontekst sprawdzony. Start serwera z 200K nie potwierdza, że 200K zostało skutecznie obsłużone. Zapisywaliśmy liczbę rzeczywistych tokenów wejścia i status zakończenia żądania.
3. Backend należy dobierać do obciążenia. Vulkan w krótkich testach potrafił wyglądać atrakcyjnie, ale w naszym teście 160K ROCm wyraźnie wygrał pod względem PP.
4. Dwie karty graficzne wymagają wiedzy o PCIe i sposobie podziału modelu. Łączna duża ilość VRAM nie oznacza automatycznie liniowego skalowania wydajności. Weryfikuj rzeczywistą szerokość połączeń i koszty synchronizacji.
5. Pamięć systemowa może być krytyczna dla MoE. Eksperyment Strata pokazał, że presja na RAM i dyskowy page cache mogą dramatycznie zmienić wynik. Samo rocm-smi nie wyjaśnia całego obrazu.
6. Spekulacja musi być mierzona na konkretnym modelu i zadaniu. MTP i DFlash zmieniały TG, ale ich zysk nie był stały; więcej tokenów draftu bywało nawet wolniejsze.
7. Profilowanie daje lepszy kierunek niż strojenie na ślepo. W badanym profilu długiego kontekstu Flash Attention odpowiadało za blisko połowę czasu kerneli. To uzasadniało dalsze eksperymenty z FA, choć nie dawało gwarancji wzrostu we wszystkich scenariuszach.
8. Najszybszy model nie jest automatycznie najlepszym programistą. Lokalne AI w roli programisty ocenia się realnym wykonaniem narzędzi, poprawnością kodu, testami jednostkowymi, walidacją oraz umiejętnością naprawiania błędów.
11. Czy warto uruchamiać lokalne AI na kartach AMD?
Po tej serii eksperymentów odpowiedź brzmi: tak — pod warunkiem że jesteśmy gotowi traktować je jak projekt infrastrukturalny, a nie instalację „jednym kliknięciem”. Dwie karty graficzne pozwoliły nam przetestować duże modele, długi kontekst, multimodalność i narzędzia agenta. ROCm i własna kompilacja llama.cpp dały dostęp do profilowania oraz optymalizacji, których nie widać z poziomu prostego okna czatu.
Nie znaleźliśmy jednej konfiguracji idealnej dla wszystkiego. W eksperymentach długokontekstowych Qwen zyskał wyraźnie na ROCm. W Strata większą rolę odegrał budżet RAM niż pozorna „jakość” kwantyzacji. W Nemotronie połączenie DFlash, Flash Attention, Q8 KV i odpowiednio przygotowanego serwera dało bardzo dobrą wydajność realnych wywołań OpenClaw.
Jeżeli mielibyśmy zdefiniować sens tej pracy jednym zdaniem, brzmiałoby ono: lokalne AI nie optymalizuje się jednym parametrem — optymalizuje się całą ścieżkę od magistrali PCIe i pamięci, przez kernelle GPU, po działanie narzędzi w agencie.
Zobacz też inne materiały o agentach AI na tej stronie: OpenClaw – asystent AI, który nigdy nie śpi, Praca z agentem AI: typowy tydzień z prawdziwego życia oraz co zmienia się, gdy agent AI pracuje w firmie.
—
FAQ: ROCm, karty graficzne, llama.cpp i OpenClaw
Czy lokalne AI na dwóch kartach AMD ma sens?
Ma, jeśli długi kontekst, narzędzia i prywatność danych są ważniejsze niż wygoda chmury. Nasze pomiary pokazują jednak, że liczy się cała ścieżka: backend, RAM, topologia PCIe i sposób podziału modelu — nie sama liczba kart.
Czy llama.cpp działa na kartach graficznych AMD?
Tak. W testowanej konfiguracji na Fedorze działał backend HIP z ROCm, wykrywając oba GPU jako architekturę GPU. Używaliśmy również Vulkan, ale jego wydajność zależała od modelu i długości kontekstu.
Czy dwie karty graficzne dają łączną pulę VRAM dla jednego modelu?
Backend może rozdzielać ciężar modelu na obie karty, lecz nie jest to przezroczysta, jednolita pamięć. Wynik zależy od podziału warstw, komunikacji przez PCIe, buforów i pozostałych elementów obliczeń.
Lokalne AI: ROCm czy Vulkan?
Nie ma uniwersalnego zwycięzcy. W naszym pomiarze Qwen Q4 z wejściem 159 520 tokenów ROCm uzyskał około 734 PP, a Vulkan około 344 PP. Krótkie testy mogą pokazywać inną relację.
Co oznacza PP i TG w benchmarkach llama.cpp?
PP opisuje szybkość przetwarzania promptu wejściowego; TG opisuje szybkość generowania kolejnych tokenów odpowiedzi. Obie wielkości trzeba raportować oddzielnie.
Czy długi kontekst działa na dwóch kartach graficznych?
Konfiguracje z 200K zostały uruchomione, a Qwen przetworzył w ukończonych benchmarkach 159 520 tokenów wejścia. Dla Nemotrona odnotowaliśmy częściowy przebieg ponad 132K tokenów, anulowany przed ukończeniem. Nie przedstawiamy tego jako pełnego testu 200K Nemotrona.
Co daje DFlash w Nemotronie?
DFlash wykorzystuje pomocniczy model przewidujący kolejne tokeny i weryfikację ich przez model główny. Potrafi zwiększać efektywną szybkość generowania, ale jego skuteczność zależy od zadania i akceptacji tokenów draftu.
Jakie parametry zastosowano w Nemotronie?
W fazie testowej: --ctx-size 204800, Flash Attention, KV Q8_0, dwa GPU, DFlash do 6 tokenów, --jinja, temperatura i top-p oraz początkowo limit budżetu rozważania. Zmiany później rozważane w OpenClaw nie są tu przypisywane do wcześniej zmierzonych wyników.
—
Metodologia, ograniczenia i źródła
Źródła wewnętrzne eksperymentu: historia naszej pracy i zrzuty logów z tegorocznych sesji benchmarkowych; m.in. sesje benchmarków Qwen 27B, narzędzia do profilowania GPU, kompilacje wariantów, logi Strata oraz log serwera podczas stress testu OpenClaw. Materiały zawierały zarówno pomiary zakończone, jak i błędy oraz próby przerwane. Wartości w wykresach są jawnie opisanymi wynikami z tych materiałów; część to średnie z kilku żądań o różnych długościach.
Dokumentacja techniczna:
– llama.cpp — oficjalna dokumentacja kompilowania, backend HIP – producent — model mixture-of-experts – AMD — dokumentacja ROCm – OpenClaw — repozytorium projektu
Granice porównania: nie prowadziliśmy identycznej serii testów jakości dla wszystkich modeli; poziom wykorzystania cache, długość promptu i mechanizm spekulacji różniły się między etapami. Nie należy przeliczać różnic w PP/TG na procentowy wzrost jakości odpowiedzi ani generalizować ich na wszystkie konfiguracje kart graficznych. Grafiki są wizualizacjami opisanych pomiarów, a nie obrazami z niezależnego laboratorium.
Nota redakcyjna: w tekście celowo nie umieszczono danych uwierzytelniających, prywatnych adresów IP ani zrzutów zawierających informacje z firmowych systemów. Konfiguracja CLI została zanonimizowana.